7. oktoober 2026 · 5 min
Open Knowledge Format: kuidas talletada teadmisi nii inimese kui ka AI jaoks
Google avaldas standardi, mis kirjeldab, kuidas organisatsiooni teadmisi hoida lihtsate tekstifailidena. Idee pole uus. Olen sama põhimõtte järgi hallanud oma märkmeid aastast 2019. Uus standard annab aga selge kokkuleppe, kuidas sellist süsteemi ka suures organisatsioonis ajakohase ja usaldusväärsena hoida.
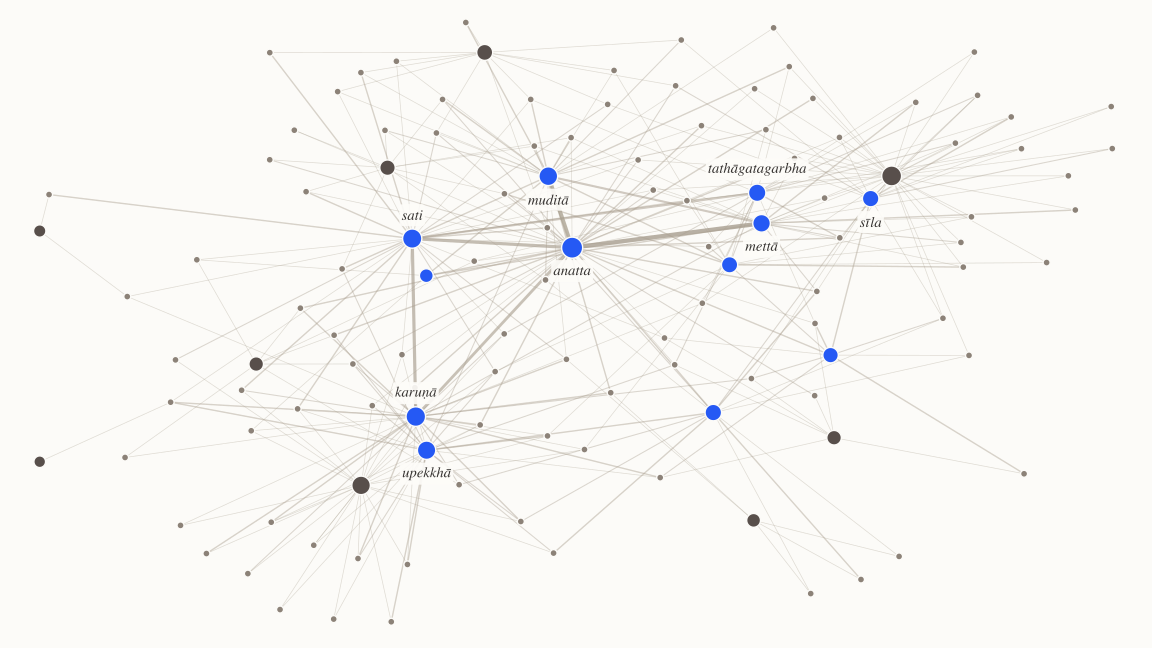
Kui ma hakkasin 2019. aastal looma süsteemi, et oma budismi õpingute märkmeid hallata, ei teadnud ma, et ehitan midagi, millele Google seitse aastat hiljem nime annab.
Tänavu juunis avaldas Google Cloud avatud standardi Open Knowledge Format (OKF). Selle eesmärk on teha oluline ja keeruline teave hõlpsasti leitavaks ja loetavaks nii inimestele kui ka AI agentidele.
Midagi päris uut OKF ei leiuta. See kasutab ammu olemas olevaid lahendusi, aga koondab parimad praktikad selgeks ja lihtsasti järgitavaks reeglistikuks. Lisaks annab see põhimõtted, kuidas hoida teadmisi korras ja usaldusväärsena ka Google'i-suuruses ettevõttes.
Teadmised ei mahu Wordi dokumenti
Igas organisatsioonis koguneb aja jooksul ohtralt kriitilise tähtsusega oskusteavet: kuidas mingi protsess käib, mida üks või teine mõõdik täpselt tähendab, miks kolm aastat tagasi tehti just too otsus. Tavaliselt on see teadmine igal pool laiali: osa jagatud dokumentides, osa meilides, osa vestlusrakendustes ja valdav osa lihtsalt eri inimeste mälus.
Sama lugu õpingutega. Budistlikus psühholoogias on sadu mõisteid, mis kõik üksteisele viitavad. Need on väga täpselt defineeritud ning nende omavahelised suhted on olulised. Täpselt nagu täppisteadustes. Seda kõike on vaja talletada nii, et ka aastate pärast oleks kõik kergesti leitav ja mõistetav.
Üks pikk dokument muutub kiiresti õudusunenäoks. Kümme eraldi dokumenti tähendab, et keegi ei tea enam, mis kus asub, sest ühest dokumendist teise dokumendi alapeatükile viitamine on raske ja habras, kui mitte võimatu.
Ja nüüd on lisandunud uus lugeja: juturobot. Kui tahad, et AI aitaks sul oma teadmistega töötada, peab ta need kõigepealt üles leidma ja läbi lugema. PDF-id, suletud rakendused ja keerulise vorminguga failid teevad selle tarbetult kulukaks, aeglaseks ja vigaseks.
Juturobotil on piiratud suurusega kontekstiaken (n-ö "mälu"). Seega ei saa ta lihtsalt kõiki su märkmeid läbi lugeda ja meelde jätta. Ta peab kiiresti üles leidma just selle, mis antud kontekstis oluline on. Mida vähem teksti tuleb selleks läbi lugeda, seda vähem token'eid see kulutab ja seda täpsema vastuse sa saad.
Kõigepealt: mis on Markdown?
OKF põhineb Markdownil, nii et alustame sellest.
Markdown on tavaline tekst, millesse on lisatud mõned lihtsad märgid. Trellid rea alguses tähendavad pealkirja, tärnide vahel olev tekst on kaldkirjas ja kriips rea alguses tähendab loetelu punkti. Näiteks:
# Viis negatiivset mõtlemist

Levinud mõtlemise vead, mille ajel teeme *ebamõistlikke otsuseid*.

- viha
- kadedus
- ahnus
- uhkus
- ignorantsus
Paljud programmid oskavad sellist teksti näidata kenasti vormindatud dokumendina: pealkirjad on suuremas kirjas, loetelud taandega ja tabelilahtrid piirjoontega. Aga ka ilma vorminduseta on see täiesti loetav.
Loomulikult saab Markdowniga teha ka oluliselt rohkemat, sealhulgas tabeleid, joonealuseid viiteid ja linke teistele lehtedele.
Markdownil on kolm omadust, mis teevad sellest hea formaadi teadmiste pikaajaliseks talletamiseks:
- See ei sõltu ühestki tootjast. Faili saab avada iga tekstiredaktoriga ka 20 aasta pärast, isegi kui täna populaarne märkmerakendus on ammu kadunud.
- Inimene saab sellest aru ilma abivahenditeta. Tähistused on nii lihtsad, et neid ei pea õppima.
- Juturobot saab sellest aru veel paremini. Suured keelemudelid on õppinud suurel hulgal Markdownis kirjutatud tekstidest ja kirjutavad ka ise oma vastused enamasti Markdownis. See on nende emakeel. Ka kõik programmeerimistööriistad saavad sellise lihttekstiga väga hästi hakkama.
Muuseas, ka see artikkel (nagu kõik minu artiklid siin lehel) on kirjutatud Markdownis.
Mida OKF sellele juurde lisab
OKF on sisuliselt kaust Markdowni faile ja käputäis kokkuleppeid. Olulisemad neist on:
- Üks fail kirjeldab üht asja. Üks mõiste, üks protsess, üks mõõdik.
- Faili alguses on metaandmete plokk YAML-vormingus. Kohustuslik on ära märkida vaid üks väli: tüüp ehk see, mis sorti dokumendiga on tegu. Juurde saab aga lisada lühikese kokkuvõtte, avaldamise kuupäeva, autori, märksõnad, allikad ja veel nii mõndagi.
- Failid viitavad üksteisele tavaliste linkidega. Nõnda jõuavad nii inimesest lugeja kui ka juturobot kiiresti teiste seotud failideni.
Üks fail võib välja näha näiteks selline:
---
type: 'Mõiste'
title: 'Valgustumine'
---

# Valgustumine

Valgustumine on vabanemine
[viiest negatiivsest mõtlemisest](./5-negatiivset-mõtlemist.md) ja
[viie positiivse mõtlemise](./5-positiivset-mõtlemist.md) täiuslik välja arendamine.
Need sulgude ja nurksulgudega asjad on lingid teistele failidele. Ja ongi kõik. Pole vaja spetsiaalset tasulist tarkvara ega kasutajakontot.
Ideaalis elab kogu see kaust Gitis (programmeerijatele tuttavas süsteemis, mis jälgib muudatuste ajalugu), aga standard seda ei nõua.
OKF-i täpne ja detailne spetsifikatsioon on toodud siin.
Minu budismi märkmed: sisult sama asi, ainult ilma nimeta
Alates 2019. aastast olen oma budismi õpingute märkmeid hoidnud just sellisel kujul: üks suur kaust tekstifailidega, kus iga õpetuse jaoks teen uue faili ning märgin selle algusesse õpetaja nime, teema ja kuupäeva. Praeguseks on mul sedasi dokumenteeritud 477 õpetuse märkmed ning see arv muudkui kasvab.
Kuna kõik on lihttekst, on sealt kerge otsida tavapäraste tarkvaraarendaja tööriistadega. Ehitasin endale isegi semantilistel vektoritel põhineva otsingumootori, et eesti ja inglise keeles kirjutatud märkmete seast vajalikud katked üles leida. Nüüd saab selle töö anda juba keelemudelile, sest Markdown on keelemudeli jaoks lemmikformaat.
Puudu oli mul aga selge kokkulepe. Aja jooksul tekkisid failid, mis kirjeldasid korraga mitut asja, ja kaustad, mille loogikat ma ise enam täpselt ei mäletanud. Üksi kirjutades saab sellega kuidagi hakkama. Kui kirjutajaid on kümme, kasvab segadus väga kiiresti. OKF-i suurim panus ongi selles, et see paneb paika lihtsad reeglid, mida kõik saavad ühtmoodi järgida ja mis on samas piisavalt vabad, et mitte tekitada ranget bürokraatiat.
Kust pihta hakata
Kui alustaksin täna tööd uues projektis, uue kliendiga või uues ettevõttes, hakkaksin sisuliselt esimese asjana olulist infot OKF-vormingus kirja panema. Projekti sisse elama pean ma niikuinii. Miks siis mitte panna see kõik kenasti kirja, et mina ise, kolleegid ja ka meie kõigi juturobotid saaksime seda kasutada?
Tööriista valik on teisejärguline. Sobib iga tekstiredaktor, aga mugavam on kasutada mõnd programmi, mis näitab linke ja vormindust ilusti, näiteks Obsidiani. Ma ise kasutan Visual Studio Code'i. Aga sobib ka lihtsalt Notepad.
Formaat elab kauem kui ükski tööriist
Märkmete tegemiseks on olemas palju toredaid rakendusi. Enamik neist kasutab enda väljamõeldud failivormingut, mida oskab avada vaid see programm ise. Olen proovinud oma märkmeid ühest süsteemist teise ümber kolida. Õudne. Jäigi pooleli.
Ja juturobotile ligipääsu andmine nõuab sellisel juhul eraldi liidestust, mille eest pead juurde maksma või mida lihtsalt ei olegi olemas.
Minu 2019. aastal kirjutatud märkmed avanevad täna samamoodi nagu toona. Hakkasin neid kirjutama Vim'iga (jah, see sama, mille eest algajaid tarkvaraarendajaid hoiatatakse, aga mis kogenud kasutajale suisa imevõimed annab), vahepeal kasutasin Obsidiani ja Typorat, nüüd Visual Studio Code'i. Tarkvara on vahetunud, aga failid on jäänud samaks. Seitse aastat tagasi ei osanud ma aimata, et ühel päeval loeb neid ka juturobot, aga tuleb välja, et valisin kogemata ka selle jaoks ideaalse formaadi.
OKF ei ole tehnoloogiline revolutsioon. Selles pole otseselt midagi uut, vähemalt tehnilised inimesed on umbes nii toiminud juba ammu. Aga see on ühtne kokkulepe, mis aitab hoida keerulisi teadmisi korras ka siis, kui keerukust on palju ja kirjutajaid on mitu.